Un modelo de lenguaje grande, o LLM por sus siglas en inglés, es un programa entrenado con enormes cantidades de texto para calcular qué fragmento de texto es más probable que siga a otro. Con esa sola operación, repetida una y otra vez, redacta correos, resume documentos o contesta preguntas en un chatbot. No consulta una base de datos de hechos verificados: produce la continuación que le parece más probable.
Qué es un modelo de lenguaje
El curso de aprendizaje automático de Google para desarrolladores define un modelo de lenguaje como un sistema que estima la probabilidad de que un token, o una secuencia de tokens, aparezca dentro de una secuencia más larga. Un token puede ser una palabra completa, un pedazo de palabra o incluso un solo carácter.
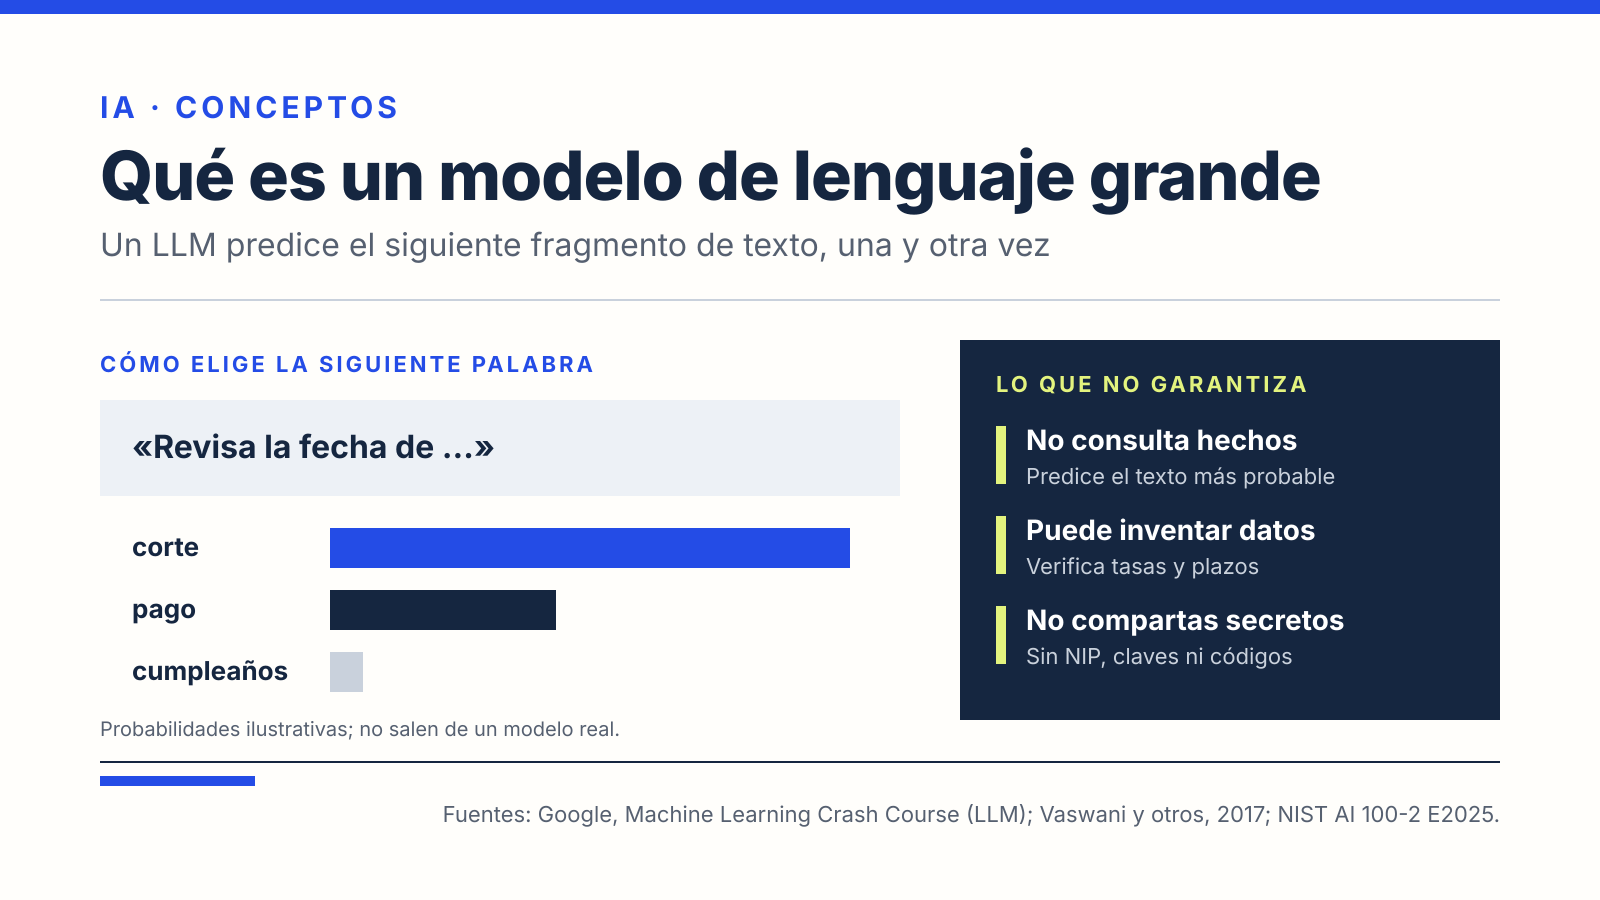
Pensemos en la frase «Antes de pagar con tarjeta, revisa la fecha de…». Un modelo de lenguaje asigna probabilidades a las posibles continuaciones: «corte» tendrá una probabilidad alta; «cumpleaños», una mucho menor. La aplicación elige entre las opciones más probables y vuelve a empezar con el texto ya ampliado.
La división en tokens depende del idioma. Google da una referencia para el inglés: un token equivale a unos cuatro caracteres, o a tres cuartas partes de una palabra. Por eso los límites de uso de muchos servicios se expresan en tokens y no en palabras.
Por qué se les llama «grandes»
Los modelos de lenguaje anteriores, como los de N-gramas, contaban qué palabras solían aparecer juntas y solo miraban unas pocas palabras hacia atrás. Según la explicación de Google, los LLM predicen mucho mejor por dos razones: tienen muchísimos más parámetros, los valores numéricos que el modelo ajusta al aprender, y toman en cuenta mucho más contexto a la vez.
Ese salto se apoya en una arquitectura llamada Transformer, presentada por investigadores de Google Brain y Google Research en el artículo «Attention Is All You Need», publicado en 2017. Su pieza central es la autoatención: para cada token, el modelo calcula cuánto influye cada uno de los demás en su significado.
Google ilustra la idea con una frase ambigua. En «El animal no cruzó la calle porque estaba muy cansado», la palabra que importa para interpretar «estaba» es «animal»; si la frase termina en «muy ancha», el peso pasa a «calle». Un modelo que ve toda la oración a la vez puede resolver esa ambigüedad mejor que uno que lee palabra por palabra.
Cómo aprende un LLM
El entrenamiento empieza con una cantidad enorme de texto. En la descripción de Google, el modelo practica con fragmentos en los que se ocultan algunos tokens y trata de adivinarlos; cada error ajusta un poco sus parámetros. Tras muchísimos ejemplos, el modelo capta gramática, estilos y relaciones entre conceptos, porque todo eso le ayuda a predecir mejor.
El resultado es un modelo base. Para que siga instrucciones o resuelva una tarea concreta se le aplica un ajuste fino: un entrenamiento adicional con ejemplos de esa tarea. Google explica que a veces bastan unos cientos o unos miles de ejemplos.
Los asistentes conversacionales suman otra etapa. En un artículo de 2022, investigadores de OpenAI describieron cómo ajustaron GPT-3 con demostraciones escritas por personas y luego con clasificaciones humanas de varias respuestas. En sus evaluaciones, las personas prefirieron las respuestas de un modelo ajustado de 1,300 millones de parámetros sobre las del GPT-3 original de 175,000 millones.
Cómo genera una respuesta
Cuando escribes una pregunta, el modelo convierte tu texto en tokens, calcula las probabilidades del siguiente token, elige uno, lo agrega al texto y repite. Una respuesta de varios párrafos es el resultado de muchas predicciones seguidas.
Las instrucciones que escribes, lo que suele llamarse prompt, no cambian el modelo. Google lo subraya: dar ejemplos en la pregunta aprovecha lo que el modelo ya sabe, pero no modifica sus parámetros. Si el servicio guarda tus conversaciones o las usa para otros fines depende de su política de privacidad, no del modelo.
El Instituto Nacional de Estándares y Tecnología de Estados Unidos (NIST) señala en su informe NIST AI 100-2 E2025 que los LLM ya alimentan buscadores, asistentes de programación y chatbots, y que se conectan a bases de documentos o a herramientas que les permiten actuar, como navegar por internet. Cada conexión amplía lo que el sistema puede hacer y también lo que puede salir mal.
Lo que un LLM no garantiza
Como el modelo produce la continuación más probable y no la verificada, puede inventar datos con un tono seguro. Google menciona las alucinaciones, el costo de cómputo y los sesgos heredados de los datos de entrenamiento entre los problemas de estos modelos. Explicamos el primero en qué es una alucinación de la IA.
Para decisiones de dinero, eso tiene tres consecuencias prácticas:
- Comprueba en la fuente oficial cualquier tasa, comisión, plazo o requisito que te dé un chatbot.
- No escribas contraseñas, NIP, códigos de verificación ni números completos de tarjeta; lo detallamos en compartir datos bancarios con ChatGPT.
- Si el asistente lee correos o páginas por ti, un texto escondido puede darle órdenes; así funciona el prompt injection.