El sesgo en la inteligencia artificial es un error sistemático que hace que un sistema funcione peor, o decida distinto, para ciertos grupos de personas. El Instituto Nacional de Estándares y Tecnología de Estados Unidos (NIST) lo agrupa en tres orígenes: las instituciones, los datos y las personas. También advierte que ningún sistema llega a riesgo cero. Saber de dónde sale el sesgo ayuda a entender por qué una app te rechaza o no te reconoce, y qué preguntar.
Tres orígenes del sesgo según el NIST
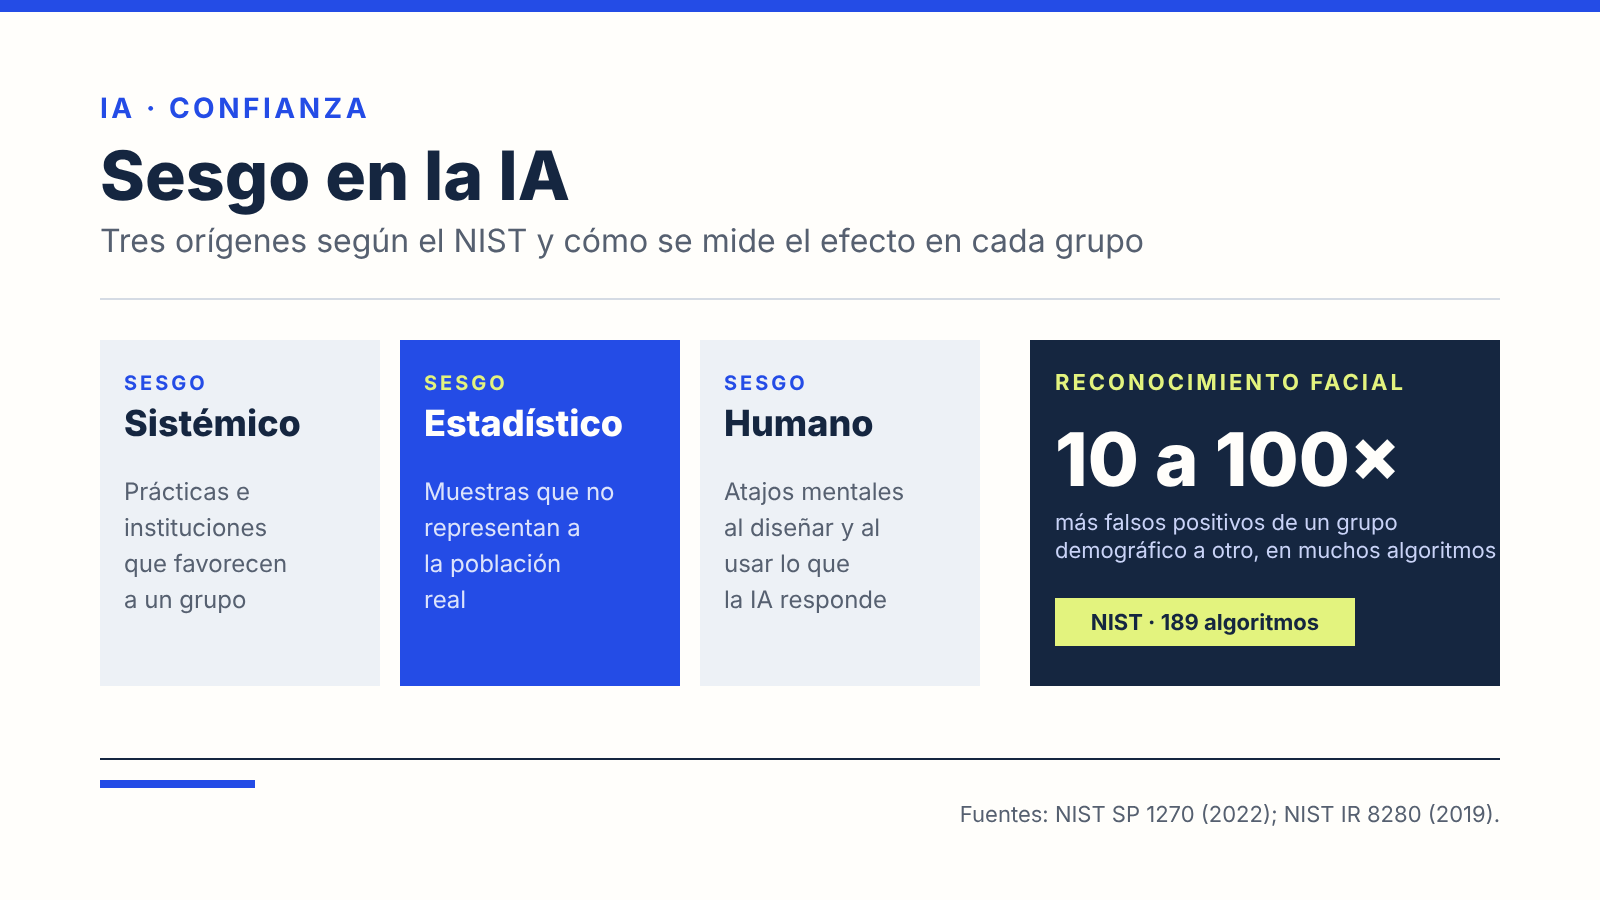
En su publicación especial SP 1270, de marzo de 2022, el NIST propone tres categorías:
| Tipo | De dónde sale | Ejemplo de cómo se ve |
|---|---|---|
| Sistémico | Prácticas de instituciones que favorecen a unos grupos y perjudican a otros, aunque nadie lo haga a propósito | Datos históricos que reflejan quién recibió crédito o empleo en el pasado |
| Estadístico y computacional | Muestras que no representan a la población, datos incorrectos o modelos que no generalizan | Un modelo entrenado con un tipo de datos que falla con personas distintas a las de la muestra |
| Humano | Atajos mentales de quien diseña, entrena o usa el sistema | Confiar en la respuesta automática sin revisarla |
El documento subraya que el sesgo no es nuevo ni exclusivo de la IA, y que no es posible lograr un riesgo cero de sesgo en un sistema de este tipo. Por eso propone gestionarlo durante todo el ciclo de vida: desde que se decide usar IA hasta que el sistema está en operación.
Quitar el dato sensible no basta
Una idea común es que basta con no darle al modelo el género, la edad o el origen de una persona. El NIST explica que eso no resuelve el problema, porque la información puede inferirse por otras variables. Pone dos ejemplos: el género puede deducirse del historial de navegación y el origen racial, del código postal. Un modelo que usa esas variables puede seguir perjudicando a un grupo sin “ver” el dato prohibido.
Como medida mientras se desarrollan mejores herramientas, el NIST sugiere reducir el número de variables de entrada, evitar que estén fuertemente correlacionadas entre sí y comprobar que cada una tenga una relación lógica con lo que se quiere predecir.
Un caso medido: el reconocimiento facial
El ejemplo con más datos públicos es el del reconocimiento facial. En el informe NIST IR 8280, de diciembre de 2019, el NIST evaluó 189 algoritmos, en su mayoría comerciales, de 99 desarrolladores, con 18.27 millones de imágenes de 8.49 millones de personas. Estos fueron sus hallazgos principales:
- En la mayoría de los algoritmos encontró diferencias demográficas. Las tasas de falsos positivos, es decir, cuando el sistema confunde a una persona con otra, variaron con frecuencia por factores de 10 a más de 100 entre grupos.
- Los falsos negativos, cuando no reconoce a la persona correcta, variaron menos, por lo general por factores menores a 3, y dependieron más de cada algoritmo.
- Los falsos positivos fueron más altos en mujeres que en hombres, y en personas mayores y en niños que en adultos de mediana edad.
- No todos los algoritmos se comportaron igual: algunos de los más precisos no mostraron diferencias detectables en falsos positivos.
Este último punto importa: el sesgo depende del sistema concreto y de cómo se configuró, no de la tecnología en abstracto. Si una app compara tu cara con una foto para verificar tu identidad, el resultado depende del algoritmo y la configuración que haya elegido quien la opera.
Cómo se detecta un sesgo
El NIST describe tres frentes de trabajo para detectarlo y reducirlo:
- Datos. Revisar si la muestra representa a la población que usará el sistema. El documento advierte que los datos suelen ser heterogéneos, sobre todo cuando no se separan por género, edad, origen o ingreso.
- Pruebas y evaluación. Medir los errores por grupo y no solo el promedio. El informe de reconocimiento facial lo hace al reportar falsos positivos y falsos negativos para cada grupo demográfico. El NIST menciona además métricas de equidad como la paridad demográfica o el impacto dispar, y aclara que ninguna responde por sí sola todas las preguntas.
- Factores humanos. Vigilar la “complacencia con la automatización”: la tendencia de expertos y operadores a tratar el resultado del sistema como objetivo y dejar de cuestionarlo.
Qué puedes hacer como usuario
No puedes auditar un modelo, pero sí pedir explicaciones. Cuándo puedes oponerte en México a una decisión tomada solo por un sistema automatizado lo explicamos en decisiones automatizadas y datos personales. Si una app te rechaza o no te reconoce varias veces, pide revisión por una persona y guarda evidencia. Y recuerda que un sistema de IA también puede equivocarse por otras razones, como explicamos en qué es una alucinación de la IA.