Google presentó Gemma 4 el 2 de abril con cuatro variantes y licencia Apache 2.0. La familia incluye E2B, E4B, un modelo de mezcla de expertos de 26.000 millones de parámetros y otro denso de 31.000 millones. Para un equipo que quiera ejecutar un modelo en su propia infraestructura, la diferencia decisiva no está solo en cuál parece más grande: también cuenta cómo utiliza la memoria y qué entradas puede procesar.
El lanzamiento combina modelos pequeños, orientados a dispositivos con recursos limitados, con alternativas mayores. Google publica evaluaciones de rendimiento para respaldar la propuesta. Esas mediciones permiten conocer su planteamiento, pero no sustituyen una prueba con el idioma, los documentos y los equipos del proyecto que vaya a utilizarlos.
Pesos disponibles y licencia: dos piezas del mismo análisis
Disponer de los pesos permite ejecutar o adaptar el modelo fuera de una aplicación cerrada, dentro de las condiciones de su licencia. Apache 2.0 ofrece un marco conocido para ese uso. Aun así, la licencia no resuelve por sí sola los derechos sobre los datos que una empresa introduzca ni las obligaciones relacionadas con su producto final.
Una organización puede valorar esta opción porque necesita controlar dónde se procesan los documentos o porque quiere ajustar una tarea específica. Eso cambia la distribución del trabajo. Si deja de delegar toda la operación en una API, tendrá que ocuparse de capacidad, actualizaciones, monitoreo y disponibilidad.
La comparación económica debe incluir ese conjunto. Una ejecución local puede reducir ciertos pagos por solicitud y, al mismo tiempo, exigir equipos, mantenimiento y tiempo del personal. No existe un ahorro universal deducible del hecho de que los pesos estén disponibles.
Por qué 26.000 millones no significa lo mismo en todos los modelos
El modelo de 26.000 millones utiliza una arquitectura de mezcla de expertos, conocida como MoE. Según Google, activa aproximadamente 3.800 millones de parámetros durante el procesamiento. La idea es seleccionar partes del modelo para cada paso, en lugar de utilizar de igual manera todos los parámetros disponibles.
Eso ayuda a entender por qué dos cifras de tamaño no se comparan directamente. Los parámetros totales, los activos y la memoria necesaria describen aspectos relacionados, pero distintos. El archivo y la arquitectura completa siguen condicionando el despliegue, aunque cada paso de cálculo utilice solo una parte.
El modelo denso de 31.000 millones sigue otra organización. La decisión entre ambos requiere medir tiempos y consumo en la carga real. Una consulta corta, un lote de documentos y una conversación extensa pueden producir resultados operativos muy diferentes.
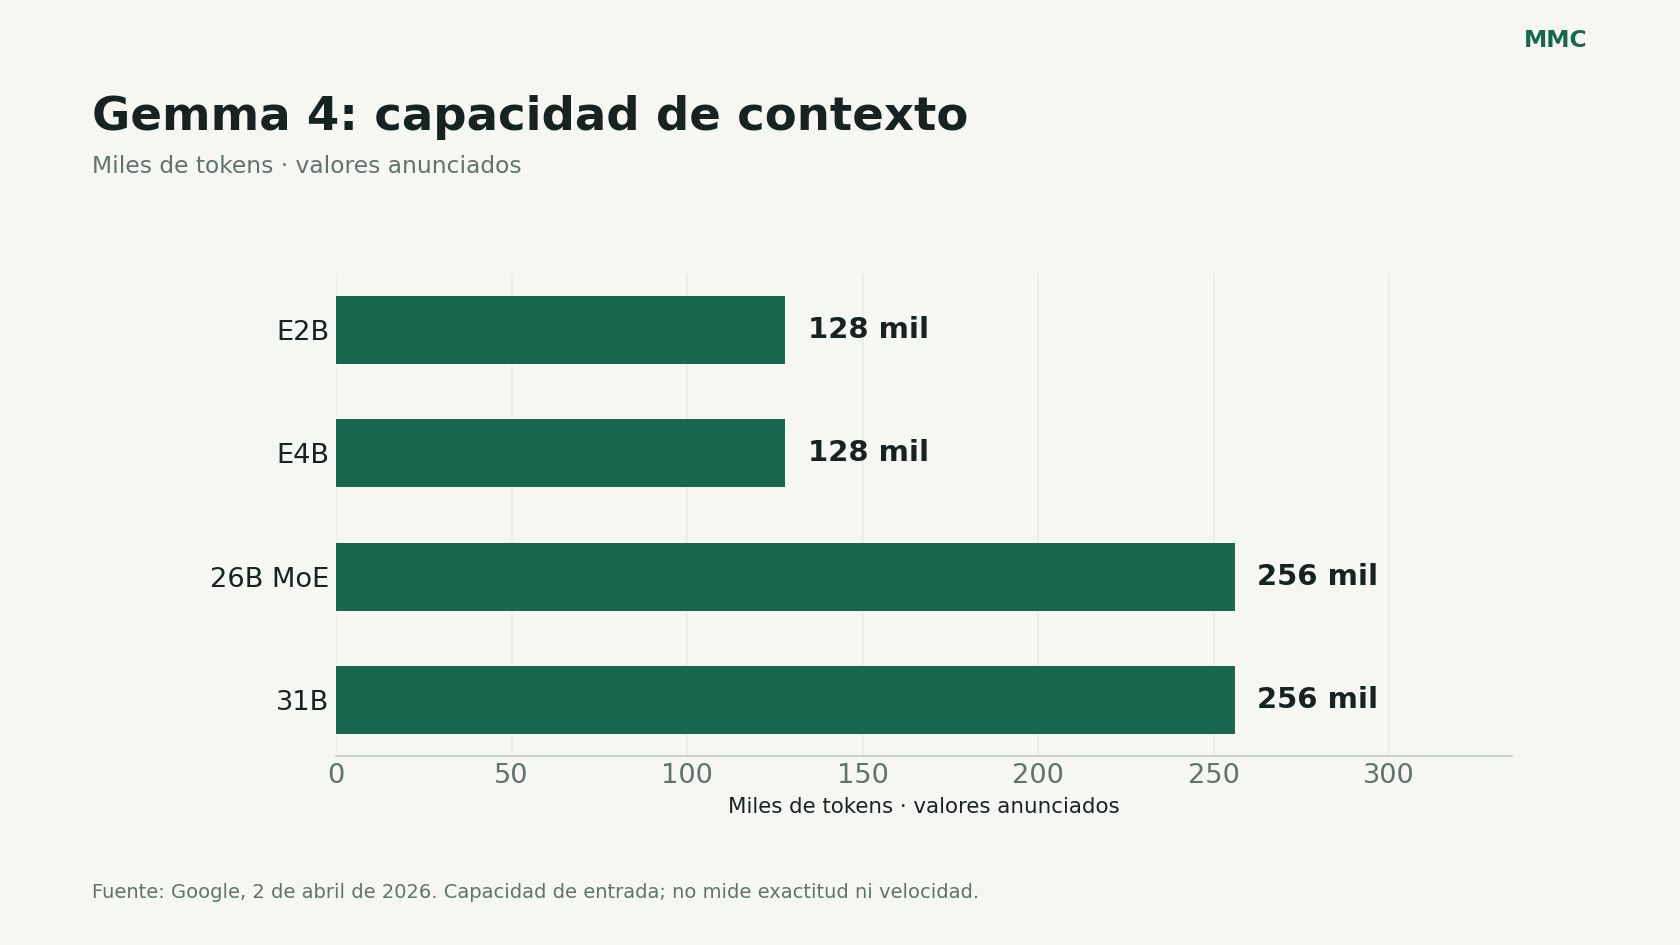
E2B y E4B: 128.000 tokens; 26B MoE y 31B: 256.000 tokens. Capacidades anunciadas por Google el 2 de abril; no son mediciones de velocidad.
Contexto, imágenes y audio
Las variantes pequeñas ofrecen una ventana de 128.000 tokens y las mayores, de 256.000. Esa capacidad describe cuánto material puede entrar en el contexto. No indica cuántos documentos comprenderá sin errores ni cuánto tardará en responder.
Google incluye procesamiento visual en las cuatro variantes. El soporte nativo de audio anunciado se concentra en E2B y E4B. Antes de escoger un modelo para transcribir mensajes o interpretar capturas, conviene verificar que admita esa entrada de la manera que requiere la aplicación.
Un flujo con comprobantes, por ejemplo, puede depender de números pequeños, signos y fechas. La evaluación debería distinguir entre reconocer el texto de una imagen y entender la relación entre sus campos. Una cifra legible en una captura no garantiza que el modelo la asocie con el período correcto.
Una prueba pequeña que aporte información útil
El primer paso es seleccionar ejemplos representativos del trabajo, incluidos casos difíciles. Pueden ser documentos con tablas, archivos largos con anexos o consultas en español con vocabulario local. El conjunto debe tener respuestas verificables, de modo que una redacción convincente no oculte una extracción incorrecta.
Después se puede comparar cada variante bajo condiciones registradas: equipo, configuración, longitud de entrada y forma de ejecución. Además de los aciertos, resulta útil observar respuestas incompletas, necesidad de corrección y estabilidad de los tiempos. La memoria máxima importa si el servicio tendrá que atender solicitudes simultáneas.
La prueba también debería incluir una salida prevista cuando falte información. Un modelo que reconoce que no encuentra una cifra puede ser más útil en un proceso documental que uno que completa el vacío con una suposición. Esa conducta debe comprobarse, no darse por sentada por el tamaño del modelo.
Gemma 4 amplía las alternativas para construir productos con mayor control sobre la ejecución. La elección de una variante se vuelve más clara cuando empieza por una tarea delimitada y un presupuesto operativo concreto. El lanzamiento aporta opciones; la evaluación aporta la evidencia para escoger entre ellas.
La distinción entre capacidad de entrada y calidad de respuesta también aparece en nuestro análisis de Opus 4.6 y los documentos largos.